LC-HRMS Fingerprinting Và Chemometrics: Cách Khoa Học Nhận Diện Và Chống Gian Lận Cà Phê
1. Vì Sao Cà Phê Dễ Bị Gian Lận?
Cà phê là một trong những đồ uống phổ biến nhất thế giới và cũng là mặt hàng dễ bị gian lận. Lý do rất thực tế: giá cà phê phụ thuộc nhiều vào giống, vùng trồng và cách canh tác. Nhìn chung, **Arabica được người tiêu dùng ưa chuộng hơn và được xem là chất lượng cao hơn Robusta**, còn cà phê trồng ở vùng cao, khó sản xuất hơn thì được đánh giá cao hơn. Khi một loại cà phê đắt hơn loại khác chỉ vì cái tên trên bao bì, động cơ pha trộn hoặc ghi nhãn sai để kiếm lợi bất chính cũng tăng theo.
Các hình thức gian lận có thể là ghi sai xuất xứ, trộn giống rẻ hơn vào giống đắt hơn, hoặc thêm chất không khai báo để tăng khối lượng. Chuỗi thương mại cà phê lại dài và phức tạp, nên nhà sản xuất và công ty nhập khẩu rất cần một phương pháp đáng tin cậy để kiểm chứng rằng cà phê không bị pha trộn dọc đường đi từ nông trại tới tách cà phê.
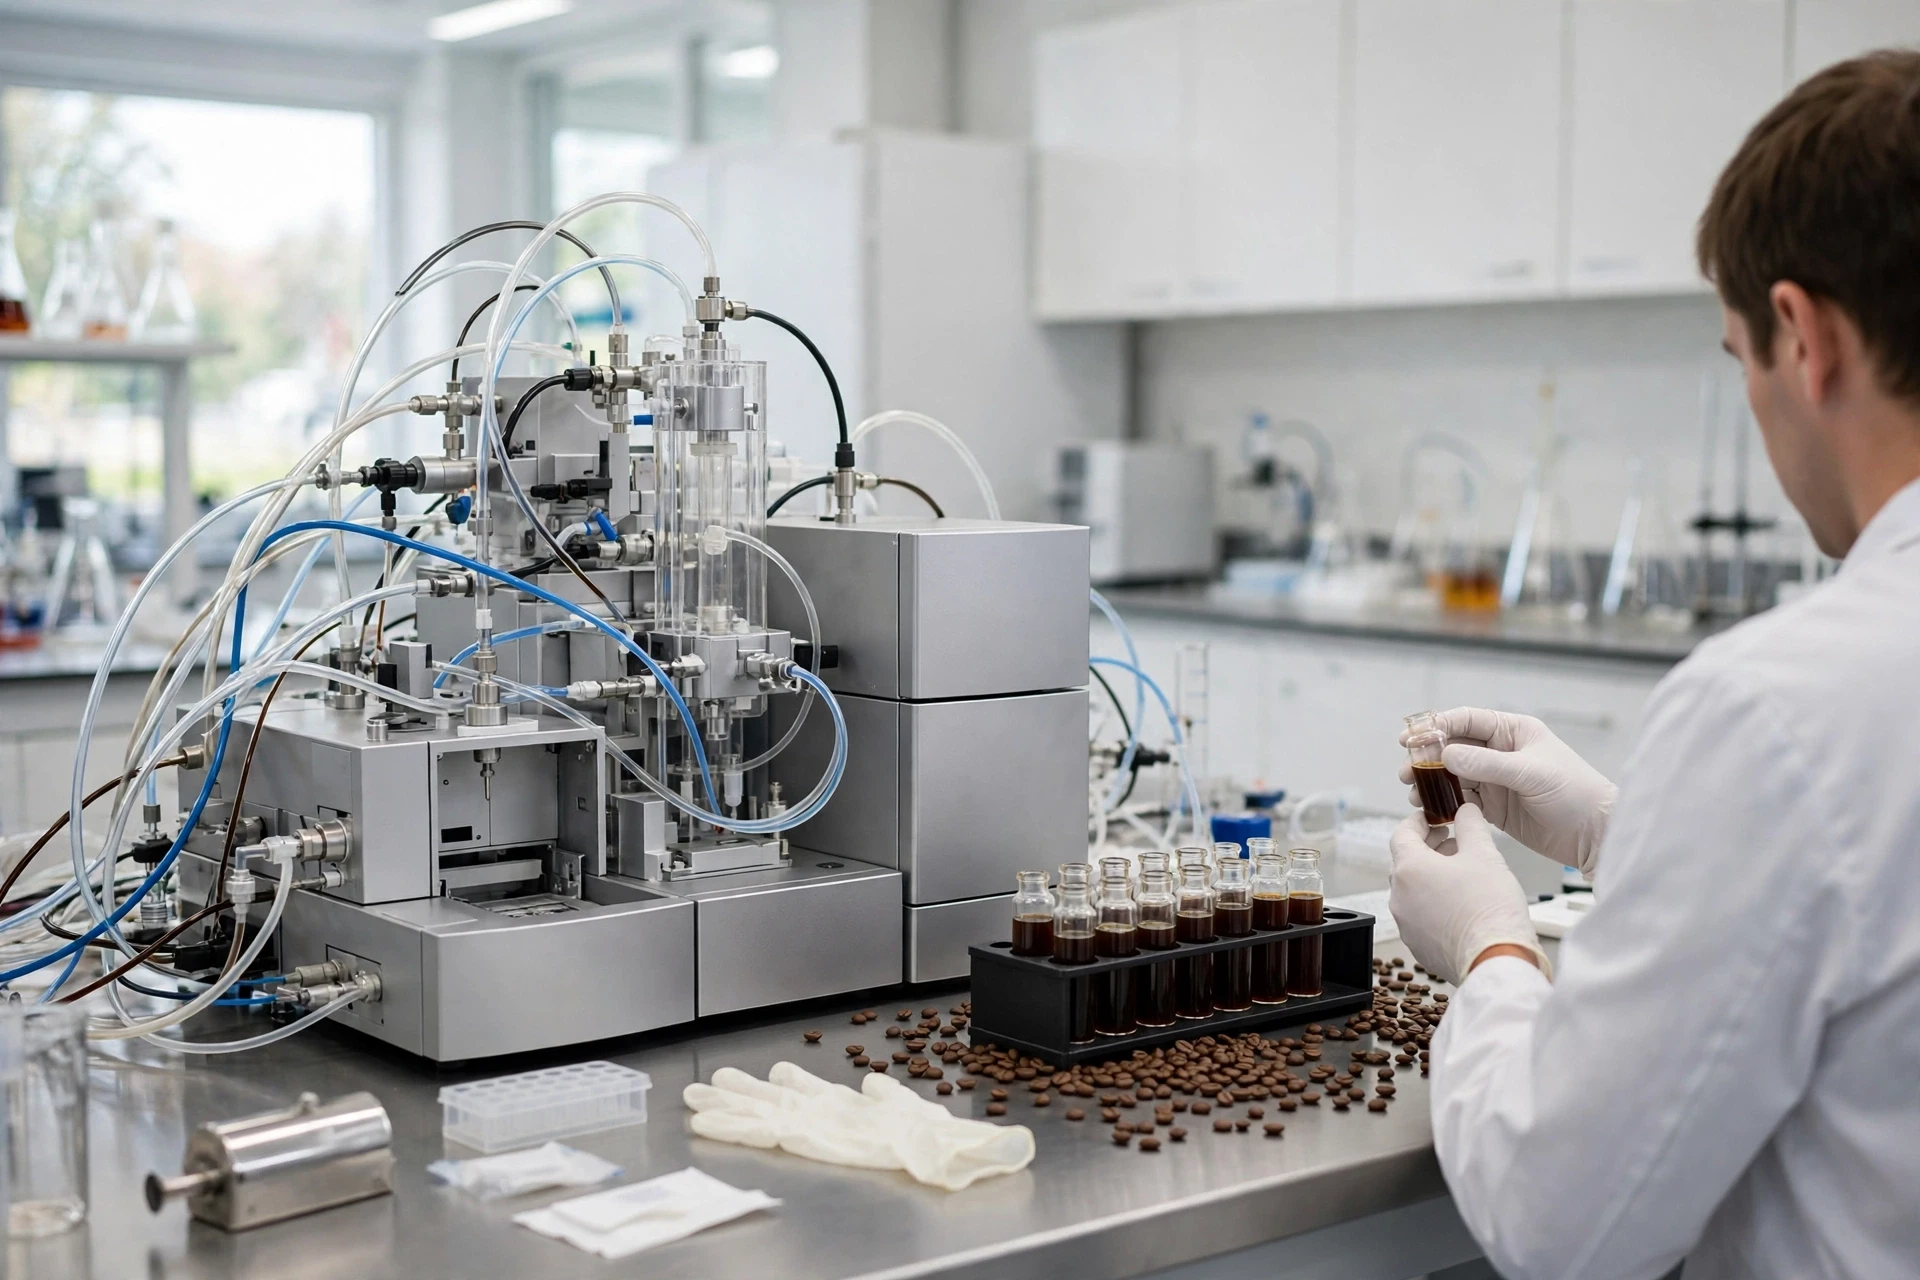
Nghiên cứu của nhóm tác giả Núñez và cộng sự (đăng năm 2024) đã thử một hướng tiếp cận hiện đại: thay vì chỉ đo một vài chất chỉ thị đã biết trước, họ ghi lại toàn bộ "dấu vân tay hóa học" của mẫu cà phê bằng kỹ thuật sắc ký lỏng kết hợp khối phổ phân giải cao, gọi tắt là **LC-HRMS**, rồi dùng thống kê đa biến (chemometrics) để phân loại mẫu. Cách làm này không cần biết trước trong mẫu có những chất nào — nó khai thác tối đa mọi tín hiệu mà máy đo được.
2. Nghiên Cứu Làm Như Thế Nào? 306 Mẫu, Pha Bằng Nước Nóng
Nhóm nghiên cứu phân tích **306 mẫu cà phê thương mại**, chia theo giống (Arabica và Robusta), vùng trồng (ví dụ Ethiopia, Colombia, Nicaragua, Indonesia, Ấn Độ, Uganda, Brazil, Campuchia và Việt Nam) và độ rang. Điểm thú vị là cách chuẩn bị mẫu rất gần với đời thường: các chất trong mẫu được chiết bằng **nước nóng, tức là pha cà phê như cách chúng ta vẫn pha**, sau đó lọc rồi đưa vào máy phân tích.
Về mặt kỹ thuật, họ dùng sắc ký lỏng pha đảo với cột C18, kết hợp máy khối phổ LTQ-Orbitrap, ion hóa bằng phun điện (electrospray) ở chế độ ion âm, quét toàn bộ trong khoảng khối lượng trên điện tích từ 100 đến 1500. Mỗi mẫu cho ra hơn **1.000 đặc trưng tín hiệu (từ 1.381 đến 1.941 đặc trưng tùy mẫu)** — một lượng dữ liệu khổng lồ mà mắt thường không thể đọc nổi. Đó chính là lúc chemometrics vào cuộc: phương pháp phân tích thành phần chính (PCA) giúp nhìn ra các mẫu tụ họp ra sao, còn phương pháp bình phương tối thiểu từng phần có phân biệt (PLS-DA) giúp xây dựng mô hình phân loại mẫu vào từng nhóm.
Một điểm mạnh mà nhóm tác giả nhấn mạnh: trong nghiên cứu này, cả ba đặc tính của mẫu — xuất xứ, giống và độ rang — đều cùng góp phần tạo nên dấu vân tay hóa học, chứ không cố định một đặc tính rồi mới xét đặc tính khác như một số nghiên cứu trước. Nhờ vậy, phương pháp được kiểm tra trong điều kiện gần với thực tế phức tạp hơn, nơi các yếu tố trộn lẫn vào nhau.
3. Phân Loại Giống Và Xuất Xứ: Chính Xác Tới Mức Nào?
Nhìn thoáng qua, các đồ thị sắc ký tổng của cà phê Arabica Brazil, cà phê Robusta-Arabica Ấn Độ và cà phê Robusta Uganda trông khá giống nhau. Nhưng khi soi kỹ, sự khác biệt hiện ra: một đỉnh rất mạnh quanh thời điểm 15 phút, các tín hiệu đặc trưng trong khoảng 2 đến 5 phút, một đỉnh ở 11,3 phút mạnh hơn ở Arabica và Robusta-Arabica, trong khi các đỉnh ở khoảng 17 đến 19 phút lại mạnh hơn ở Robusta. Có những tín hiệu dường như chỉ xuất hiện ở một số loại cà phê nhất định, ví dụ quanh 24 và 28 phút. Chính những khác biệt tinh tế về số lượng đỉnh và cường độ tương đối này là "chất liệu" để mô hình phân loại làm việc.
Khi dùng mô hình PLS-DA dạng cây — tức là loại trừ dần từng nhóm theo từng bước, ví dụ tách Uganda ra trước rồi mới phân biệt các nhóm còn lại — kết quả phân loại theo vùng trồng rất khả quan. Ở tập hiệu chuẩn, độ chính xác, độ nhạy và độ đặc hiệu phần lớn **đều trên 92,5%, 92,9% và 92,3%**, sai số phân loại dưới 7,4%. Ở tập dự báo (mẫu mới mà mô hình chưa từng thấy), các chỉ số vẫn đạt trên 91,7%, 83,3% và 81,3%, sai số dưới 9,3%. Một số nhóm như Brazil, Trung và Nam Mỹ, Ấn Độ hay Uganda đạt độ chính xác dự báo **100%** trong tập 1.
Với độ rang, mô hình cây cũng cho kết quả tốt: ở tập hiệu chuẩn, độ chính xác trên 95,7%, độ nhạy trên 92,9%, độ đặc hiệu trên 96,4% và sai số dưới 5,4%; ở tập dự báo, các chỉ số tương ứng vẫn trên 87%, 83,3% và 83,3%, sai số dưới 16,6%. Nhóm tác giả nhận xét rằng kết quả này tương đương hoặc nhỉnh hơn một chút so với các phương pháp fingerprinting bằng HPLC-UV và HPLC-FLD trước đây, với lợi thế bổ sung là dữ liệu LC-HRMS về sau còn có thể dùng để truy tìm các chất chỉ thị sinh học tiềm năng nếu cần.
4. Thử Thách Khó Nhất: Phát Hiện Pha Trộn Giữa Các Vùng Gần Nhau
Phân loại mẫu nguyên chất đã khó, nhưng phát hiện pha trộn còn khó hơn — nhất là khi kẻ gian trộn hai loại cà phê trồng gần nhau, khí hậu tương tự nhau. Nhóm nghiên cứu đã cố tình chọn ba trường hợp được kỳ vọng là khó phát hiện nhất: **Robusta Việt Nam pha với cà phê Campuchia; Arabica Việt Nam pha với cà phê Campuchia; và Arabica Việt Nam pha với Robusta Việt Nam**. Với người tiêu dùng Việt Nam, đây là những trường hợp rất gần gũi và thực tế.
Mỗi trường hợp được chuẩn bị các mức pha trộn để hiệu chuẩn (từ 100% cà phê gốc xuống 0%, theo bước 20%) và các mức để kiểm chứng (15%, 25%, 50%, 75%, 85% chất pha trộn), mỗi mức lặp lại 5 lần, tổng cộng 55 mẫu chiết cho mỗi trường hợp. Sau đó, mô hình hồi quy PLS được dùng để ước lượng tỷ lệ pha trộn từ dấu vân tay hóa học.
Kết quả cho thấy phương pháp này có thể **định lượng mức pha trộn tới 15%**, với hệ số tương quan trên 0,995 ở cả ba trường hợp. Sai số hiệu chuẩn đều dưới 2,7% (thấp nhất chỉ 0,74% với trường hợp Arabica Việt Nam pha Campuchia), còn sai số dự báo dưới 11,6% (cao nhất 11,6% với trường hợp Arabica Việt Nam pha Robusta Việt Nam). Nói cách khác, ngay cả khi chỉ pha 15% cà phê khác vào, phương pháp vẫn có khả năng phát hiện và ước lượng được mức pha trộn — một kết quả có ý nghĩa thực tế lớn cho kiểm soát chất lượng và chống gian lận.
5. Phương Pháp Này Có Hạn Chế Gì?
Không có phương pháp nào hoàn hảo. Với phân loại độ rang, một số nhóm ở tập dự báo vẫn còn "chưa sạch": ví dụ mức rang 2/5 ở tập 2 chỉ đạt độ nhạy 72,5% và sai số phân loại 26,1% khi dùng mô hình PLS-DA đơn lẻ, trước khi áp dụng mô hình cây để cải thiện. Điều này cho thấy độ rang là đặc tính khó phân tách hơn, vì các mẫu khác giống vẫn có thể chồng lấn lên nhau trên đồ thị PCA.
Ngoài ra, đây là nghiên cứu trong phòng thí nghiệm với mẫu thương mại và quy trình chuẩn hóa. Để áp dụng rộng rãi, phương pháp cần được kiểm chứng thêm trên nhiều lô hàng, nhiều mùa vụ và điều kiện bảo quản khác nhau, đồng thời cần cân nhắc chi phí thiết bị LC-HRMS phân giải cao — không phải phòng kiểm nghiệm nào cũng có sẵn. Tuy vậy, ưu điểm lớn là khâu chuẩn bị mẫu rất đơn giản (pha bằng nước nóng rồi lọc), không cần quy trình chiết phức tạp hay chất chuẩn đắt tiền cho từng chất mục tiêu.
Kết Luận: Dấu Vân Tay Hóa Học Là Tấm Căn Cước Của Cà Phê
Nghiên cứu này cho thấy một tách cà phê pha bằng nước nóng cũng mang đủ thông tin hóa học để trả lời ba câu hỏi quan trọng: đây là giống gì, trồng ở đâu và rang tới mức nào — và quan trọng hơn, nó có bị pha trộn hay không, pha bao nhiêu phần trăm. Với người tiêu dùng, điều đó có nghĩa là trong tương lai, những tuyên bố như "100% Arabica Việt Nam" hay "single origin Ethiopia" sẽ ngày càng khó bị làm giả mà không bị phát hiện.
Với ngành cà phê, thông điệp cũng rõ ràng: đầu tư vào xác thực không chỉ là chuyện phòng thí nghiệm, mà là cách bảo vệ giá trị của người trồng thật, nhà rang thật và người uống thật. Khi gian lận bị phát hiện tới mức 15%, lợi nhuận từ việc pha trộn sẽ ngày càng mỏng đi — và đó là tin tốt cho tất cả những ai làm cà phê tử tế.
Nguồn: Núñez N. và cộng sự, "Liquid Chromatography–High-Resolution Mass Spectrometry (LC-HRMS) Fingerprinting and Chemometrics for Coffee Classification and Authentication", tạp chí Molecules, 2024, PMCID: PMC10780290.
Đừng bỏ lỡ mẻ rang mới.
Nhận thông tin micro-lot theo mùa, công thức pha và ưu đãi cho khách lẻ hoặc quán cà phê.